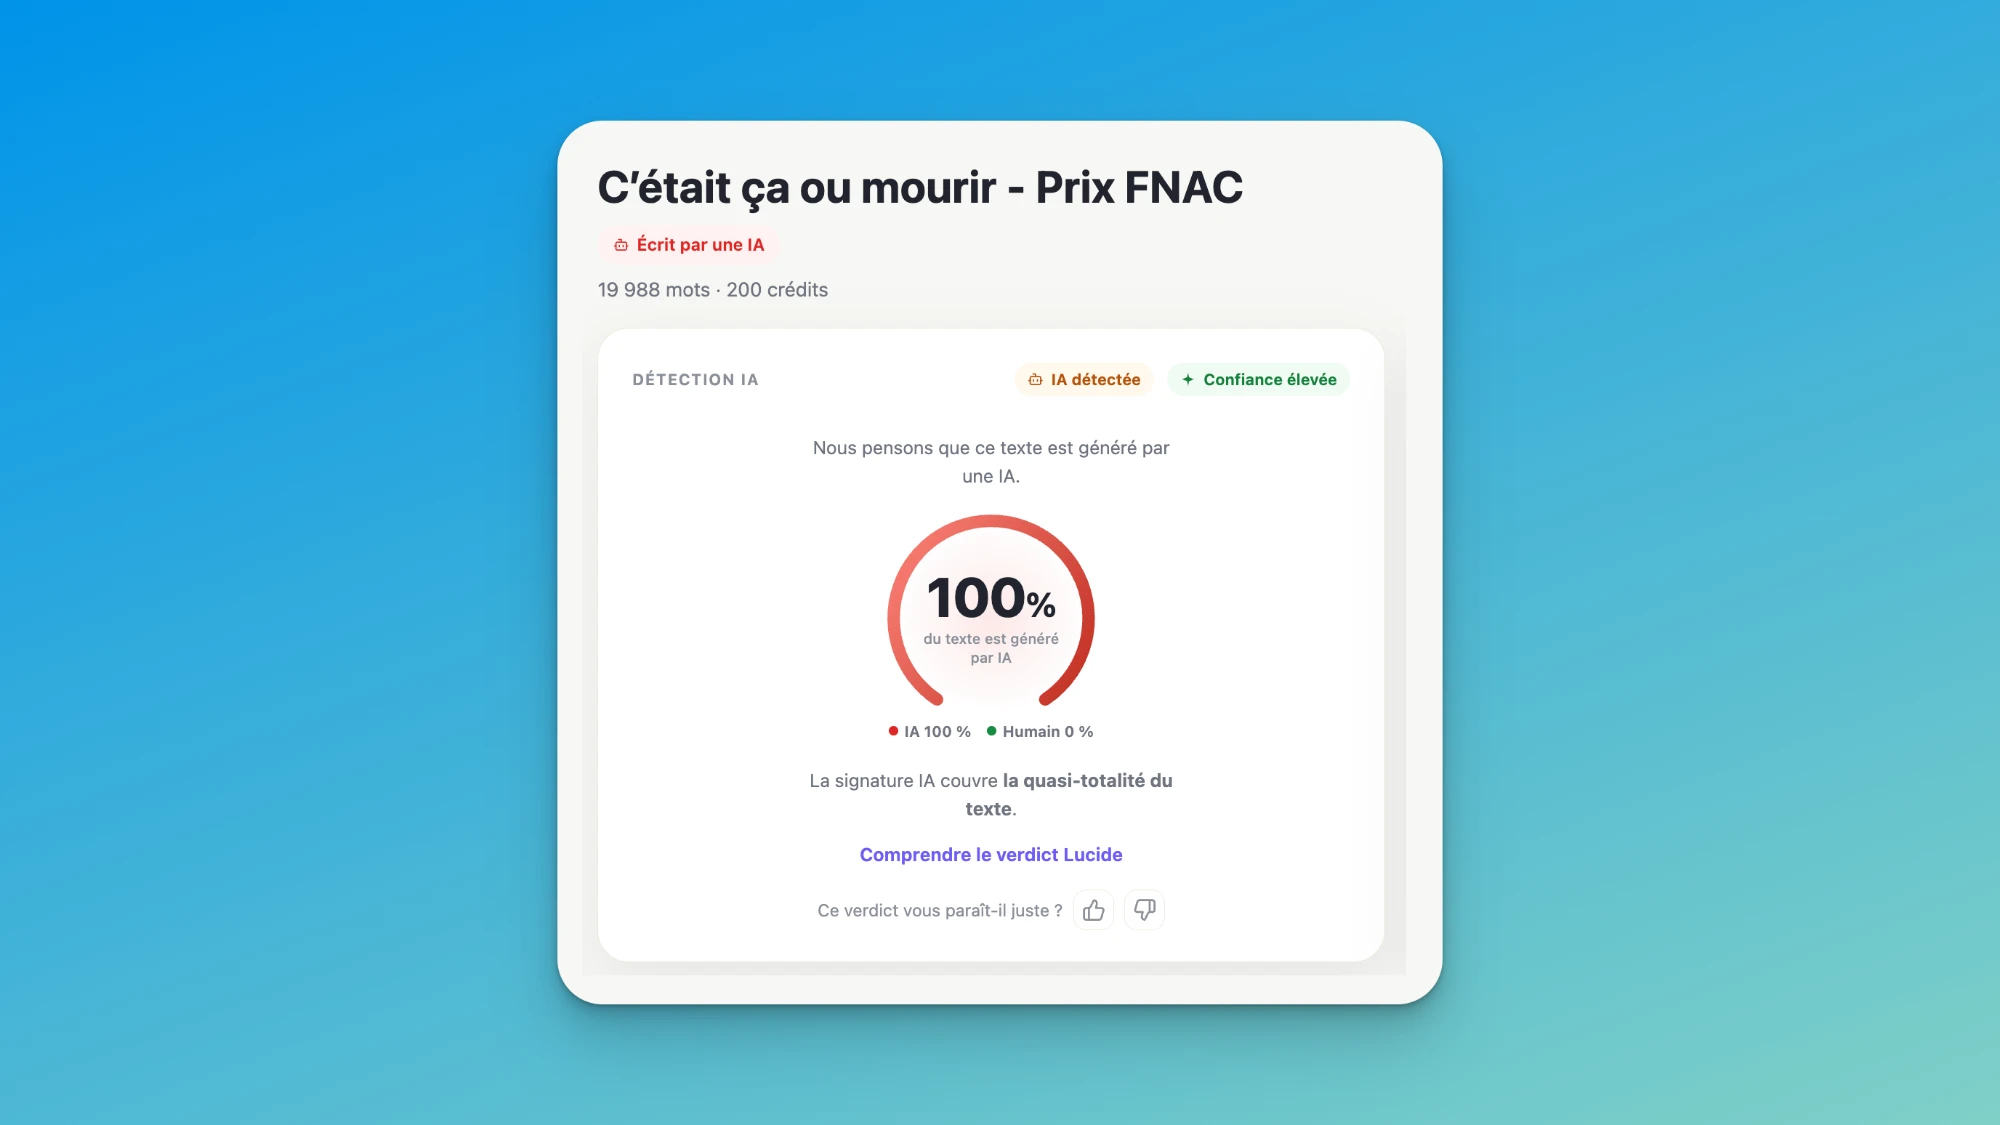
L’essentiel à retenir : nous avons soumis les 59 488 mots de « C’était ça ou mourir » à Lucide 3.0, le moteur qui sert nos clients depuis la mi-septembre. Les 34 chapitres et l’épilogue sont classés générés par IA, 34 d’entre eux avec une part générée de 100 %, le dernier à 96,7 %. Quatre passes sur de grandes parties du livre (13 500 à 17 900 mots d’un seul tenant) donnent le même résultat. Dix textes témoins publiés avant 2022, dont trois de l’auteur lui-même, sont classés humains, sans un seul mot classé généré. Nous avons ensuite passé 17 autres livres en entier, 706 chapitres et 1 298 945 mots : dix best-sellers français de l’année, et sept romans d’auteurs haïtiens et africains pour vérifier que le moteur ne se déclenche pas sur cette écriture-là. Aucun de ces 706 chapitres n’est classé généré. Un détecteur ne dit ni qui a eu l’idée du livre, ni comment le texte a été produit : les limites de la mesure sont détaillées plus bas.
Le 21 septembre, le jour où il recevait le prix du Roman Fnac, le premier roman de Thélyson Orélien a été accusé sur X d’avoir été écrit par une intelligence artificielle. Le compte, anonyme, s’appuyait sur un détecteur concurrent du nôtre et disait avoir obtenu « 100 % IA » sur une vingtaine de passages. Grasset, l’éditeur français, a répondu le lendemain en parlant de rumeurs et de théorie du complot, et en rappelant que ces outils se trompent. L’auteur, lui, dit avoir écrit ce livre « avec ses tripes », nourri de témoignages d’exilés haïtiens recueillis depuis 2017.
Nous fabriquons un détecteur. La question nous concerne donc directement, et nous avions les moyens d’y répondre autrement que sur un extrait ou deux : en passant le livre entier, avec des témoins, et en publiant la méthode.
Ce qui est en jeu
Le livre pèse lourd. Paru en mars au Québec chez Boréal, puis le 19 août en France chez Grasset, il s’est vendu à plus de 35 000 exemplaires en un mois, figure dans les premières sélections du Goncourt, du Renaudot, du Femina, du Médicis et du prix Décembre, et doit être traduit dans une vingtaine de pays. Les jurys vont devoir se prononcer d’ici novembre. Un détecteur peut les aider à poser la question. Il ne peut pas la trancher à leur place.
Ce que nous avons fait
Le texte. L’édition numérique de Boréal, parue en mars, cinq mois avant l’édition Grasset. 34 chapitres et un épilogue, de 1 032 à 2 602 mots chacun, soit 59 488 mots sans les pages de titre, la dédicace et les remerciements.
Le moteur. Lucide 3.0, tel qu’il tourne en production, sans réglage particulier. Il rend pour chaque texte la part de mots qu’il classe comme générés par une machine. Une part de 0 % veut dire qu’il n’a rien repéré, une part de 100 % que le texte entier lui paraît produit par un modèle. Le verdict affiché au client en découle : « très probablement écrit par une IA » au-delà de 80 %.
Les passes. Chaque chapitre a été soumis seul, comme le ferait un lecteur qui teste un extrait. Nous avons ensuite soumis quatre grandes parties du livre d’un seul tenant, de 13 480 à 17 879 mots, pour vérifier que le résultat ne dépend pas du découpage.
Les témoins. Un détecteur qui classe un roman généré doit aussi savoir dire non. Un résultat isolé ne vaut donc rien sans des textes dont nous savons qu’ils sont humains, passés dans le même moteur, le même jour, avec les mêmes réglages. Nous avons construit le corpus témoin en trois couches, chacune répondant à une objection précise.
Couche 1, l’auteur lui-même, avant 2022. Trois chroniques de Thélyson Orélien publiées en 2013 et 2014 sur Mediapart et sur le HuffPost Québec, de 398 à 1 387 mots. Si le moteur prenait sa plume pour celle d’une machine, il devrait se tromper ici aussi. Réserve assumée : ce sont des chroniques, pas de la fiction, et nous n’avons trouvé aucun texte littéraire de lui antérieur à 2022.
Couche 2, de la prose littéraire qu’on accuse volontiers de « sonner IA ». Quatre extraits de 1 500 mots du journal de Sylvain Tesson « Une très légère oscillation » (2017), fait de phrases courtes et d’aphorismes, et trois extraits de 1 500 mots de la traduction française de « Tragédie à l’Everest » de Jon Krakauer (1997), un récit à la première personne. Sept extraits, tous antérieurs à 2022.
Couche 3, 17 livres entiers. Nous avons acheté et passé en entier, chapitre par chapitre, dix des meilleures ventes françaises de l’année et sept romans d’auteurs haïtiens et africains, dont six publiés avant 2022. Soit 706 chapitres et 1 298 945 mots, contre 59 488 pour le roman en cause. Ces livres répondent à deux objections différentes : les best-sellers disent si le moteur accuse la littérature française contemporaine en général, les auteurs haïtiens et africains disent s’il se déclenche sur une écriture afro-caribéenne. Le détail des deux groupes est plus bas.
Résultats
| Passe | Mots | Part de mots générés | Verdict |
|---|---|---|---|
| Chapitres 1 à 11 | 17 879 | 100 % | Généré |
| Chapitres 12 à 19 | 13 830 | 100 % | Généré |
| Chapitres 20 à 28 | 14 299 | 100 % | Généré |
| Chapitres 29 à 34 et épilogue | 13 480 | 100 % | Généré |
Chapitre par chapitre : 35 unités sur 35 classées générées, 34 à 100 %, le chapitre 23 à 96,7 %. Le moteur distingue le texte généré du texte humain retouché par une machine : la part « assistée », celle d’un texte humain repassé par un modèle, est nulle sur les 35 unités. Ce qu’il voit, c’est du texte produit par un modèle, du premier au dernier chapitre, sans zone humaine.
| Témoin | Année | Mots | Part de mots générés | Verdict |
|---|---|---|---|---|
| Thélyson Orélien, chronique Mediapart | 2013 | 1 387 | 0 % | Humain |
| Thélyson Orélien, chronique Mediapart | 2014 | 1 319 | 0 % | Humain |
| Thélyson Orélien, HuffPost Québec | 2014 | 398 | 0 % | Humain |
| Sylvain Tesson, journal, 4 extraits | 2017 | 4 × 1 500 | 0 % | Humain |
| Jon Krakauer (traduction), 3 extraits | 1997 | 3 × 1 500 | 0 % | Humain |
Dix témoins sur dix classés humains, sans un seul mot signalé.
Dix des meilleures ventes de l’année
Un détecteur qui classe un roman généré doit aussi savoir dire non. Nous avons donc acheté dix des meilleures ventes françaises de l’année et nous les avons passées en entier, chapitre par chapitre, avec la même méthode que le roman.
| Livre | Auteur | Année | Chapitres | Classés générés |
|---|---|---|---|---|
| D’autres printemps | Virginie Grimaldi | 2026 | 60 | 0 |
| Une unique lueur | Fred Vargas | 2026 | 65 | 0 |
| Et la joie de vivre | Gisèle Pelicot | 2026 | 18 | 0 |
| Les heures fragiles | Virginie Grimaldi | 2025 | 66 | 0 |
| Je suis Romane Monnier | Delphine de Vigan | 2026 | 50 | 0 |
| L’Autre moi | Franck Thilliez | 2026 | 66 | 0 |
| Les Belles promesses | Pierre Lemaitre | 2026 | 57 | 0 |
| Le Crime du paradis | Guillaume Musso | 2026 | 34 | 0 |
| Fauves | Mélissa Da Costa | 2026 | 31 | 0 |
| L’Adolescence du perroquet | Amélie Nothomb | 2026 | 13 | 0 |
Au total 460 chapitres, 835 983 mots, aucun classé généré. 14 chapitres sur 460 ressortent mixtes, dispersés chez six auteurs, le plus chargé à 0,40 de part générée. Pour mémoire, le roman d’Orélien donne 34 chapitres à 1,00 et un à 0,97.
Sur un extrait d’environ 5 000 mots de chacun de ces dix livres, le verdict affiché par notre produit va de 92 à 100 sur 100, côté humain. Le roman en cause affiche 0.
Des auteurs haïtiens et africains, pour tester le reproche de biais
Depuis le 21 septembre, une objection revient : le détecteur prendrait une langue afro-caribéenne pour de la machine, et l’accusation viserait un auteur noir et haïtien. L’entourage de l’auteur l’a formulée dans la presse. Cette objection se teste, au moins en partie.
Nous avons pris sept romans d’auteurs haïtiens et africains et nous les avons passés en entier, chapitre par chapitre, avec la même méthode. Six d’entre eux sont publiés avant 2022, donc impossibles à générer. Le cas le plus intéressant est celui de Louis-Philippe Dalembert : auteur haïtien, roman de traversée clandestine, paru en 2019, soit le voisin le plus direct du livre en cause par la langue et par le sujet. Aucun de ses 33 chapitres ne contient pourtant un seul mot classé généré.
| Livre | Auteur | Année | Chapitres | Classés générés |
|---|---|---|---|---|
| Mur Méditerranée | Louis-Philippe Dalembert, haïtien | 2019 | 33 | 0 |
| Les villages de Dieu | Émmelie Prophète, haïtienne | 2020 | 49 | 0 |
| L’énigme du retour | Dany Laferrière, haïtien | 2009 | 52 | 0 |
| Rapatriés | Néhémy Pierre-Dahomey, haïtien | 2017 | 21 | 0 |
| La plus secrète mémoire des hommes | Mohamed Mbougar Sarr, sénégalais | 2021 | 55 | 0 |
| Frère d’âme | David Diop, franco-sénégalais | 2018 | 20 | 0 |
| Aucune nuit ne sera noire | Fatou Diome, franco-sénégalaise | 2025 | 16 | 0 |
Les 155 chapitres des quatre auteurs haïtiens ne contiennent aucun mot classé généré, et pas un seul chapitre mixte. Le moteur ne se déclenche donc pas sur cette langue, y compris quand le livre raconte la même chose, dans la même région du monde, avec du créole dans les dialogues.
Ce test règle une partie de la question, pas toute. Il montre que l’écriture afro-caribéenne ne déclenche pas notre détecteur. Il ne dit rien des intentions de la personne qui a lancé l’accusation sur X, et aucun outil de mesure ne pourra le faire.
Les limites de ce résultat
Nous tenons à cette partie autant qu’aux chiffres.
Un détecteur mesure une ressemblance. Il a appris, sur des millions de textes, à quoi ressemble la prose d’un modèle de langue et à quoi ressemble celle d’un humain. Il ne sait rien des intentions. Il ne peut pas distinguer un roman généré à partir d’un synopsis d’un manuscrit humain intégralement réécrit par un modèle : dans les deux cas, chaque phrase a été produite par la machine et le résultat sera le même. Il ne dit pas qui a eu l’idée du livre ni qui a recueilli les témoignages. Il ne dit pas non plus quel modèle a été utilisé.
35 chapitres ne font pas 35 preuves. Ils viennent de la même main et du même travail éditorial. Si le moteur se trompait sur cette écriture, il se tromperait 35 fois. C’est pour cela que les témoins comptent plus que le nombre de chapitres : dans les textes que l’auteur a publiés en 2013 et 2014, le moteur ne classe aucun mot comme généré. L’hypothèse d’un style qui « piège » le détecteur ne résiste pas à ce test. Une réserve tout de même : ce sont des chroniques, pas de la fiction. Nous n’avons pas trouvé de texte littéraire de l’auteur antérieur à 2022.
Notre taux d’erreur sur l’humain est mesuré. Sur le banc d’essai que nous avons publié le 22 septembre, 168 textes humains en français, aucun n’est accusé. Sur les 2 758 articles de 2021 de notre étude du web français, 0,1 % sont classés générés. Et sur les 17 livres passés en entier pour cet article, 706 chapitres et 1 298 945 mots, aucun.
Deux outils indépendants disent la même chose. Le détecteur cité dans l’accusation et le nôtre ont été construits par des équipes différentes, avec des données différentes. Qu’ils convergent sur l’ensemble du livre rend l’erreur moins probable qu’avec un seul outil. Elle ne l’exclut pas : les deux ont appris ce qu’est un « style de machine », et un même angle mort peut les toucher tous les deux.
Ce qui tranchera. Pas un détecteur. Des brouillons datés, un historique de versions : ce qu’un auteur qui a travaillé un texte pendant des années possède en général, et qu’un éditeur peut demander avant de répondre « fake news ». Nous publierons ici la réponse de l’auteur ou de son éditeur s’ils souhaitent nous l’adresser, à support@lucide.ai.
Et maintenant ?
Ce qui nous frappe, c’est la façon dont ce résultat est arrivé : par un compte anonyme, sur des extraits, le jour d’un prix. Les jurys et les éditeurs ont tout intérêt à ne pas découvrir ce genre de question sur les réseaux sociaux. Un contrôle sérieux porte sur le livre entier et s’appuie sur des témoins. Il se fait avant la liste finale, pas après. Il commence par une question simple posée à l’auteur au moment de la signature : avez-vous utilisé un modèle de langue, et pour quoi faire ?